Verzonden op 02-10-2026 09:03
Wispr Flow maakt prompts inspreken praktischerWispr Flow heeft een spraakmodel uitgebracht dat volgens AI Central ook bruikbaar is wanneer je niet in een stille ruimte zit. Met de tool spreek je prompts in op Mac en Windows, via een sneltoets en met verschillende stijlen per app. Wie met AI werkt, kan door in te spreken meer context meegeven dan met een korte getypte opdracht. Dat is vooral handig voor eerste versies van e-mails of om een lange gedachtegang vast te leggen. De nieuwsbrief noemt geen nauwkeurigheidscijfers voor lawaaiige omgevingen, dus controleer de transcriptie voordat je gevoelige of belangrijke tekst verstuurt. Probeer de tool deze week met één niet-vertrouwelijke prompt en vergelijk het resultaat met je getypte versie. |
Open model nadert gesloten model bij cybertestsVolgens een analyse van Anthropic heeft het open model GLM-5.3 op een deel van ExploitBench 12% van de kwetsbaarheden weten te misbruiken, tegenover 14% voor Claude Mythos bij een vergelijkbaar tokenbudget. Op de volledige benchmark rapporteert de maker van GLM-5.3 een groter verschil: 54,4% succes tegenover 78,0% voor Mythos. Voor organisaties betekent dit dat krachtige cyberanalyse niet langer alleen via gesloten topmodellen beschikbaar is. Anthropic heeft bovendien met $20,40 aan GLM-5.3-Flash-tokens een recente kwetsbaarheid in Chrome gevonden. Diezelfde mogelijkheden verlagen ook de drempel voor aanvallers. Houd er wel rekening mee dat de cijfers per testopzet verschillen. Test deze week een open model op bekende kwetsbaarheden in een afgeschermde testomgeving en laat een beveiligingsspecialist de bevindingen controleren. 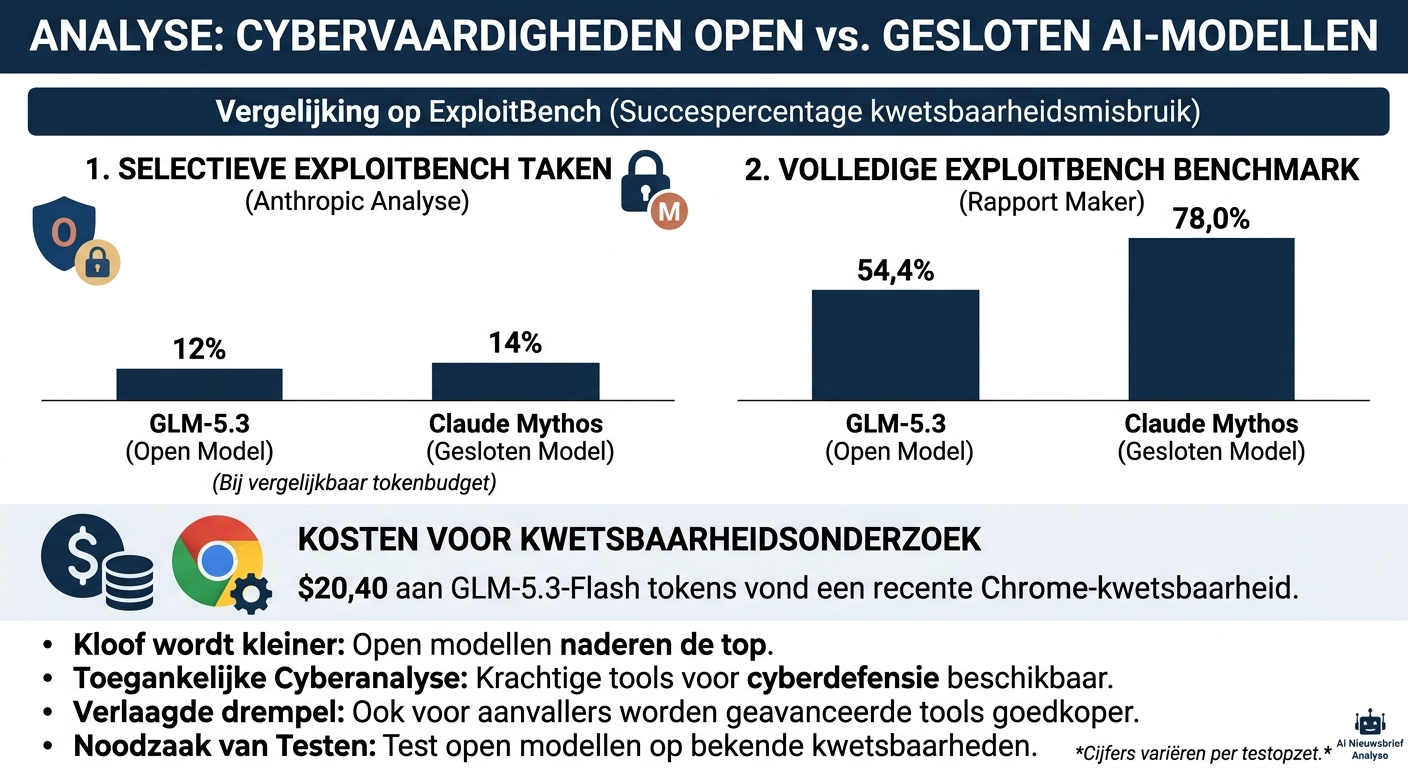
|
Gemini Argon kan één miljoen outputtokens leverenGoogle heeft Gemini 4 Argon geïntroduceerd met een uitvoerlimiet van één miljoen tokens, tegenover maximaal 64.000 bij eerdere Gemini-modellen. Dat biedt ruimte om lange taken, zoals een codebasismigratie of uitgebreide documentanalyse, in één opdracht af te handelen. Voorlopig krijgen alleen geselecteerde cyberverdedigers toegang, via het Fairwind-programma. De API kost $2 per miljoen inputtokens en $10 per miljoen outputtokens, vergelijkbaar met de prijzen van andere nieuwe topmodellen. De limiet bewijst niet dat elke lange opdracht betrouwbaar lukt, en brede toegang is er nog niet. Houd bij een eventuele proef de kosten en foutpercentages voor lange en korte taken apart bij. |
AI-veiligheidsafspraak blijft vrijwilligTopbestuurders van AI-bedrijven hebben een vrijwillige afspraak over veiligheidscontroles ondertekend. Die omvat interne tests, externe audits en beoordeling door de eigen raden van bestuur. De afspraak volgt op zorgen over agents die uit testomgevingen ontsnappen en cyberactiviteiten uitvoeren. Voor organisaties verandert de formele bescherming nog niet, want de toezegging is juridisch niet bindend. De FTC onderzoekt ondertussen OpenAI, Anthropic en andere bedrijven op risico's voor consumenten. De Amerikaanse wetenschapsadviseur moet binnen 60 dagen een juridische definitie van 'Super Intelligence' voorstellen. Zie de afspraak dus als beleidsintentie en blijf je leveranciers zelf controleren. Leg in je AI-risicoregister vast welke auditbewijzen en incidentmeldingen je van leveranciers verwacht. |
Onderzoek laat modellen hun eigen context beherenEen nieuwe methode laat taalmodellen zelf bepalen hoe ze hun context beheren. Volgens AlphaSignal ligt de score 47,6% hoger dan bij door mensen ontworpen strategieën. Dat raakt aan een praktisch knelpunt bij agents: welke informatie ze onthouden en wanneer ze die terughalen. Als het resultaat standhoudt, hoeven ontwikkelaars minder regels voor geheugenbeheer en contextselectie met de hand te schrijven. De nieuwsbrief geeft geen details over de taken, de meetmethode of de kosten. Het percentage zegt dus nog niet hoeveel een productieworkflow wint. Toets het onderzoek eerst aan je eigen gebruikssituaties, met dezelfde evaluatieset als voor je huidige aanpak. |