Verzonden op 30-09-2026 08:12
OpenAI herstelt fout in beeldherkenning van GPT-6OpenAI heeft een bug verholpen waardoor GPT-6 Sol en GPT-6 Luna afbeeldingen in API-verzoeken verkeerd interpreteerden. De fout kon daardoor ook antwoorden beïnvloeden in werkprocessen die al op deze modellen draaiden. Laat je team documenten, grafieken of foto’s analyseren? Controleer dan eerder verwerkte resultaten opnieuw. De melding vermeldt niet hoe groot de fout was of welke gebruikssituaties precies getroffen zijn. Herhaal beeldtests die representatief zijn voor je toepassing en vergelijk ze met de eerdere uitvoer. |
Sonnet 5.5 verlaagt de kosten van AI-coderenClaude Sonnet 5.5 scoort 70,6% op Terminal-Bench 4.0, tegenover 10,3% voor Sonnet 5 en 66,4% voor Opus 5.5. Volgens Anthropic is het model tot 30% sneller en goedkoper per taak dan zijn voorganger, terwijl de prijs gelijk blijft. Het ondersteunt een context van 1 miljoen tokens en maximaal 128.000 outputtokens. Voor teams die code of grote documenten met AI verwerken, kan dat meer werk binnen hetzelfde budget opleveren. Benchmarks voorspellen alleen niet één op één hoe het model op je eigen code presteert. Test Sonnet 5.5 deze week daarom op een terugkerende codeertaak en vergelijk de kwaliteit met die van je huidige model, inclusief doorlooptijd en tokengebruik. 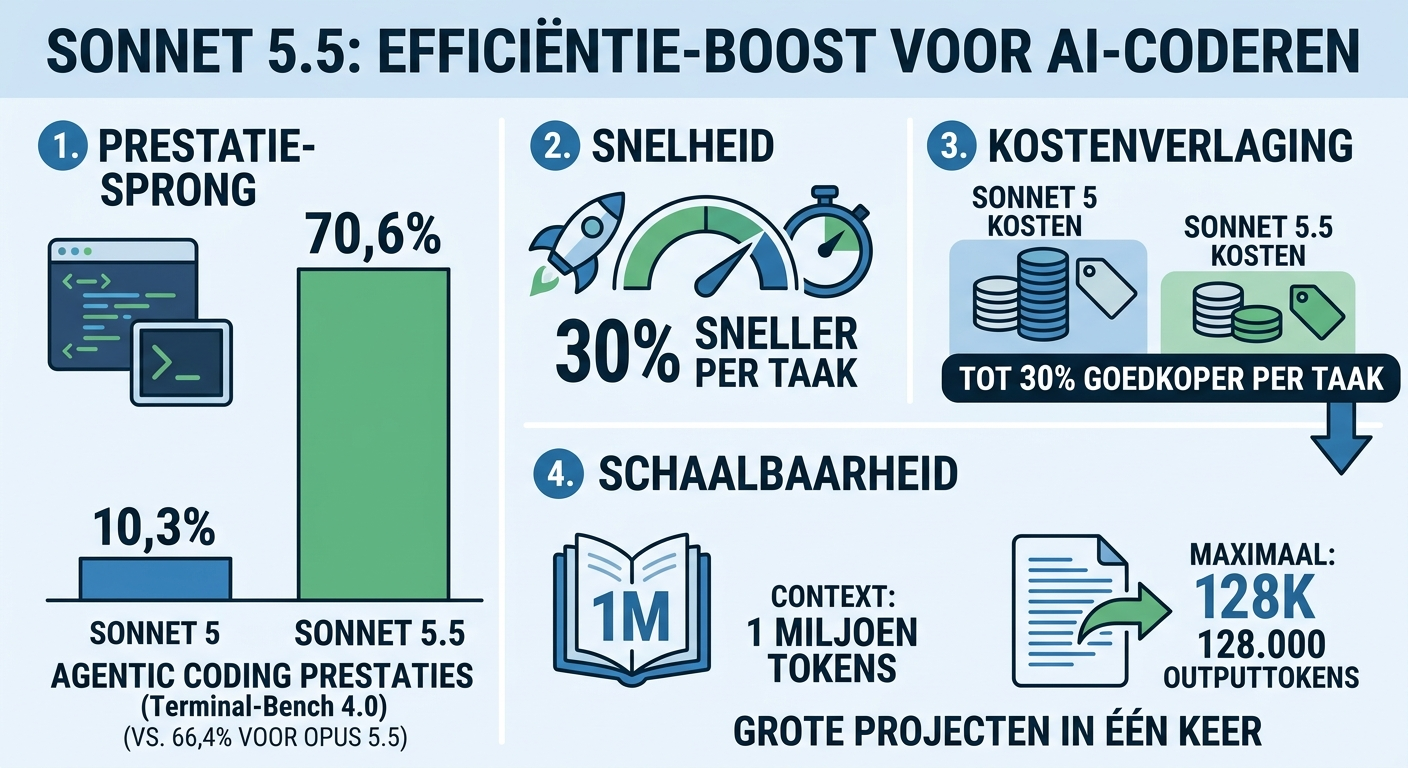
|
CodeAF haalt meer uit open codemodellenCodeAF, een open-source harness voor codeeragents onder Apache 2.0, loste op DeepSWE bijna vier keer zoveel GitHub-issues op als Claude Code met hetzelfde open model. Volgens de aanbieder kostte een opgeloste issue ongeveer de helft van wat de eerstvolgende harness ervoor rekende. Daarmee wordt de manier waarop je een model aan tools en taken koppelt een factor bij de keuze voor een coding-agent, naast het model zelf. De cijfers komen uit één benchmark en zeggen niets over hoe CodeAF presteert op jouw repository. Test het met tien afgeschermde issues uit je eigen backlog en vergelijk de uitkomsten met je huidige aanpak.
|
Grok Team Bots maken gedeelde agents voor teamsxAI heeft Team Bots beschikbaar gemaakt voor Teams- en Enterprise-abonnementen. Je kunt een bot rond een rol of workflow bouwen en die met collega's delen. De bot houdt persoonlijke gesprekscontext gescheiden van gedeelde teamkennis. Organisaties kunnen zo terugkerende werkwijzen in een gedeelde agent vastleggen, in plaats van prompts per medewerker te laten verschillen. De aankondiging geeft geen onafhankelijke cijfers over nauwkeurigheid of productiviteitswinst. Spreek vooraf af welke teaminformatie de bot mag onthouden en wie die kan aanpassen. |
Onderzoeksagent van Google scoort op 86 taken beter dan menselijke papersEen autonome onderzoeksagent van Google heeft volgens AlphaSignal op 86 taken 25% beter gepresteerd dan menselijke papers. Dat wijst op mogelijke waarde voor onderzoek waarin een systeem zelfstandig meerdere stappen uitvoert. Voor R&D-teams telt vooral of de agent ook op hun eigen vakgebied reproduceerbare resultaten levert, buiten een benchmark. De mail geeft geen details over de taken of de beoordelingsmethode, dus wees terughoudend met de vergelijking. Bekijk de evaluatie voordat je het resultaat gebruikt om onderzoekswerk te plannen. |
Wajo koppelt AI-agent aan menselijke assistentenWajo heeft de aanmeldingen geopend voor Fo, een persoonlijke agent die menselijke assistenten inschakelt zodra de AI een taak niet zelfstandig kan afronden. Volgens het bedrijf verbetert deze aanpak het vertrouwen en de taakafronding. Voor organisaties is het model interessant bij taken waarbij uitzonderingen of menselijk oordeel nodig zijn, zonder dat de hele workflow handmatig hoeft te verlopen. Een onafhankelijke controle van de aangehaalde benchmark ontbreekt, en de mail noemt geen concrete cijfers. Behandel de claims daarom als onbewezen totdat je de aanpak zelf hebt getest. |