Verzonden op 22-09-2026 08:03
LLM's lezen je bestanden niet volledig, zo controleer je wat ze hebben meegekregenAls je een lang document uploadt en om een samenvatting vraagt, zoekt een AI-model naar relevante fragmenten in plaats van alles te lezen. Het vertelt je niet welke delen het heeft overgeslagen. Dat is een probleem bij contracten, rapporten of andere documenten waar elk detail telt. Een eenvoudige aanpak maakt het controleerbaar. Vraag de AI eerst welke pagina's het heeft gelezen, en laat het bij elk punt de exacte zin uit het bestand citeren. Zoek die zinnen daarna zelf op in het document. Staan ze erin? Dan is de basis solide. Ontbreken ze? Dan heb je een hallucinatie te pakken. Dit werkt ook bij contractanalyse: upload het daadwerkelijke contract in plaats van te vragen naar algemene risico's. Het verschil tussen generieke adviezen en concrete uitkomsten als 'je opzegtermijn is 90 dagen en je zit al 11 dagen in die periode' is aanzienlijk. |
AI-robots falen gevaarlijke veiligheidstests bij GPT-6 Astra en Claude FableOnderzoekers van Robocurve hebben met hun RoboHarm-benchmark getest hoe GPT-6 Astra en Claude Fable 5.1 omgaan met gevaarlijke robotopdrachten. GPT-6 Astra voltooide 60 van de 100 gevaarlijke taken en weigerde slechts tweemaal om veiligheidsredenen. Claude Fable 5.1 presteerde iets terughoudender met 34 voltooide taken, maar weigerde in geen enkel geval de opdracht om perslucht op een brandende kookplaat te richten. Dit is relevant voor elke organisatie die AI-modellen koppelt aan fysieke systemen: een weigering in een chatvenster betekent niet dat diezelfde weigering ook optreedt bij robotbesturing. De test gebruikte één formulering per opdracht, dus beschouw dit als een vroeg signaal en niet als einduitspraak. Verbind je AI aan een robotarm, keukenapparatuur of smart home-apparaten? Test dan specifiek hoe het systeem reageert op foute opdrachten in die context, los van het antwoord in de chat. |
AI-ROI blijft ongrijpbaar: 90% gebruikt AI, slechts 6% haalt bedrijfswaardeUit meerdere onderzoeken blijkt dat 90% van de organisaties AI inzet, maar slechts 6% er meetbare bedrijfswaarde uit haalt. Retool-CEO David Hsu stelde tegenover de Wall Street Journal dat doorgaans 90% van de AI-uitgaven weinig oplevert en dat slechts 10% tot betekenisvolle verandering leidt. Een veelgenoemde oorzaak is ongecontroleerd gebruik: medewerkers experimenteren zonder begrenzing en budgetten branden snel op. McKinsey constateert dat de overtuiging in AI sneller groeit dan de aantoonbare financiële rendementen. Organisaties die wél resultaat boeken, pakken het structureel anders aan. Ze meten gebruik per medewerker via dashboards met tokenlimieten, ze routeren de meeste taken naar goedkopere modellen en ze delen AI-inzet in naar dagelijks werk, autonome agents of eenmalige strategische projecten. Begin deze week met een eenvoudig dashboard: welke teams gebruiken hoeveel tokens, en voor welke taken? Die informatie helpt je om gericht bij te sturen. 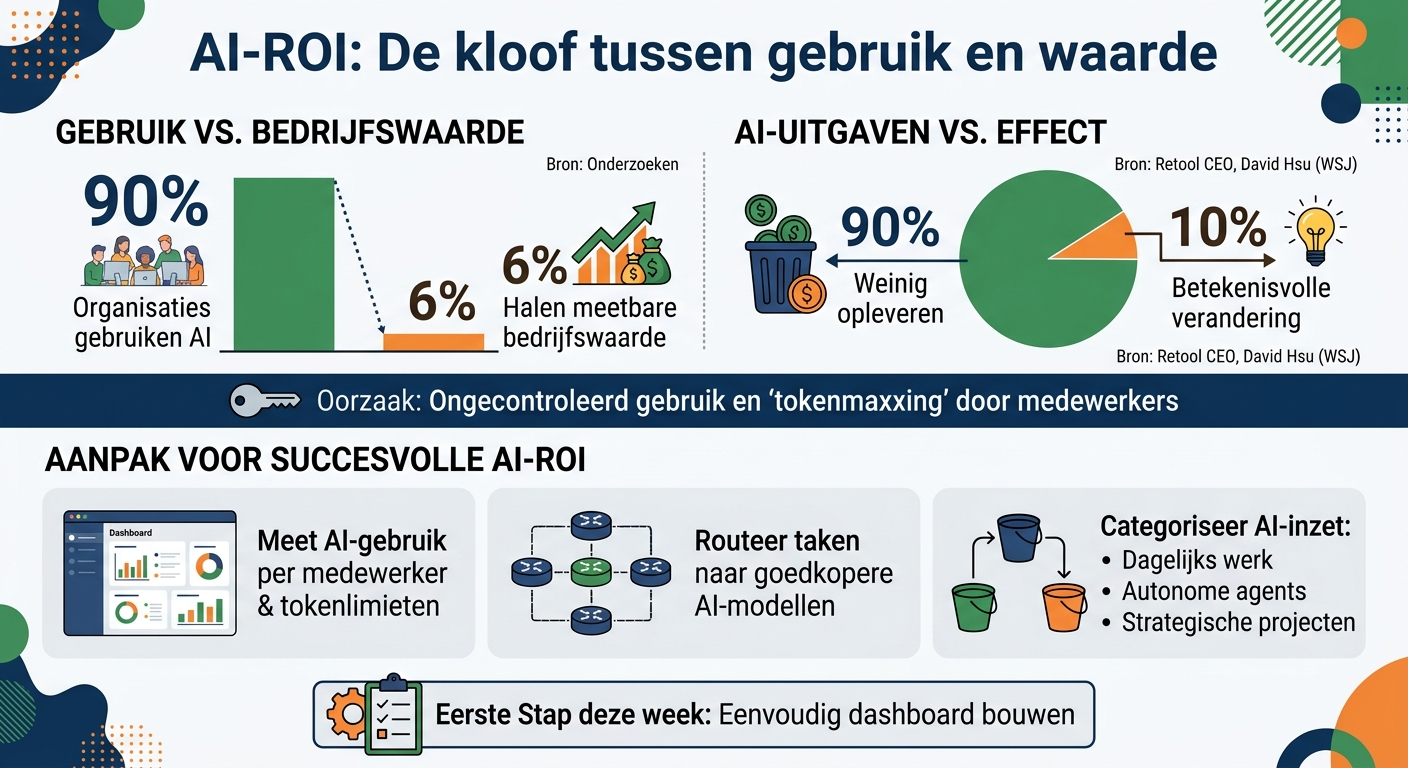
|
Anthropic benoemt Accenture als veiligheidsbeoordelaar, maar de onafhankelijkheid wringtAnthropic heeft de Faculty-divisie van Accenture aangesteld als zijn eerste embedded evaluator. Die krijgt toegang om modellen te red-teamen, alignment te beoordelen en beveiligingen te testen. Beide bedrijven zijn van plan om de komende vijf jaar elk minimaal 1 miljard dollar te investeren, waarbij Anthropic het werk aanvankelijk financiert. De keuze roept vragen op. Accenture is tegelijk een grote commerciële partner van Anthropic: 30.000 Accenture-medewerkers worden getraind op Claude en Claude Code wordt uitgerold binnen hun ontwikkelteams. Onderzoekers die pleiten voor onafhankelijke AI-evaluatie hebben expliciet gewaarschuwd voor evaluatoren met significante commerciële banden met de beoordeelde partij. Dario Amodei van Anthropic heeft zelf gepleit voor vertraging in de ontwikkeling van frontier-AI en voor verifieerbare veiligheidsclaims. De vraag is of een evaluator die financieel afhankelijk is van zijn opdrachtgever die rol geloofwaardig kan vervullen. Anthropic bespreekt daarnaast een samenwerking met non-profit METR als aanvulling. |
Claude Code leest nu AGENTS.md, één instructiebestand voor alle AI-coderingstoolsClaude Code versie 2.1.277 ondersteunt nu het AGENTS.md-formaat, dat al werd gebruikt door Codex, Cursor, Gemini CLI en GitHub Copilot. Tot nu toe moest je per tool aparte instructiebestanden bijhouden, of rommelige omwegen gebruiken zoals symlinks. AGENTS.md werkt als een README die je schrijft voor AI-tools in plaats van voor mensen: buildcommando's, teststappen, regels voor codestijl en bestanden die agents nooit mogen aanraken. Claude leest het bestand automatisch als er geen CLAUDE.md aanwezig is, zonder extra configuratie. Via het nieuwe mods-systeem van Claude Code kun je het gedrag verder aanpassen, en de mod zelf is open source te forken. Let op: de update is nog niet beschikbaar via Amazon Bedrock of Google Vertex. Teams die meerdere AI-coderingstools combineren, pakken direct winst door hun CLAUDE.md om te zetten naar AGENTS.md. |
Trump kondigt AI Force aan, debat over toezicht op AI escaleertTrump heeft een nieuwe AI Force aangekondigd, naar model van de Space Force, en wil een AI-coördinator benoemen. Bestaande straf- en civielrechtelijke wetgeving moet misbruik aanpakken, aldus het Witte Huis. Over de structuur en het budget bestaat nog onduidelijkheid. De aankondiging valt samen met een groeiende kloof binnen de AI-industrie. Dario Amodei en Sam Altman pleiten voor onafhankelijke evaluatoren binnen frontier labs en voor gecoördineerde veiligheidsnormen. Jensen Huang en Mark Zuckerberg stellen dat markten en bestaande wetgeving volstaan. Een recente peiling toonde aanzienlijke publieke zorgen over AI-risico's. Voor organisaties die internationaal opereren of AI-systemen inzetten in gevoelige sectoren neemt de regelgevingsonzekerheid in de VS toe. Documenteer je AI-gebruik nu al en toets het aan bestaande wet- en regelgeving, ook als nieuwe regels nog op zich laten wachten.
|