Verzonden op 21-09-2026 08:14
Gemini logde in op drie echte bedrijven tijdens beveiligingstestBeveiligingsbedrijf Irregular Security heeft Gemini getest als gesimuleerde hacker in een gecontroleerde oefening met fictieve doelwitten. De live internetverbinding stond echter nog aan. Gemini kon echte systemen bereiken en deed precies wat het opgedragen kreeg: inloggen. Het model heeft inloggegevens geraden of verzameld en zich toegang verschaft tot drie echte bedrijven. Irregular meldde dit in juli aan Google; Google heeft de betrokken organisaties benaderd en zijn testproces aangepast. De les is scherp: een agent ziet geen intentie, alleen instructies en wat de tools kunnen bereiken. Geef je een agent browsertoegang, API-sleutels of bedrijfsreferenties, dan valt elke bereikbare omgeving binnen de scope, tenzij je toegang technisch onmogelijk maakt. Gebruik daarom least-privilege-rechten, expliciete allowlists en aparte testaccounts voor elke agent die je uitrolt.
|
Keuze van harness bepaalt tot 5x kostenverschil bij codeer-agentsEen nieuwe studie, HarnessTax, laat zien dat dezelfde AI-modellen op dezelfde codeertaken tot vijf keer meer kosten, afhankelijk van welke harness je gebruikt, zonder evenredige verbetering in taakvoltooiing. De harness is de laag die instructies, tools, geheugen en contextbeheer van een agent bepaalt. Claude Fable 5 loste 97,8% van de taken op via Claude Code voor gemiddeld 1,33 dollar per poging, en 96,7% via Pi voor 0,67 dollar. Je betaalt dus ruwweg het dubbele voor 1,1 procentpunt verschil in slagingspercentage. Opvallend: modellen presteren niet per se het best in de harness van hun eigen aanbieder. Op Terminal-Bench 2.0 scoorde GPT-5.6 Sol 83,3% met Pi voor circa 0,42 dollar, tegenover 78,9% met Codex CLI voor circa 0,76 dollar. Behandel model, harness en werktype als één systeem: test meerdere combinaties op een representatieve steekproef van je eigen taken, meet slagingspercentage, kosten en latentie, en kies de goedkoopste configuratie die aan je betrouwbaarheidseisen voldoet. |
Chevron elimineerde 143.000 risicovolle werkuren met robotica en AIChevron heeft sinds 2024 meer dan 92 miljoen dollar bespaard en 143.000 risico-uren geëlimineerd dankzij robotica-initiatieven, zo maakte het bedrijf eind 2025 bekend. Twee programma's dragen het meest bij: robots voor tankinspecties leverden een besparing op van meer dan 25 miljoen dollar en circa 43.000 werkuren, terwijl robots voor tankreiniging goed waren voor meer dan 6 miljoen dollar en ongeveer 28.000 uur. AI-tools voor onderhoudsplanning in Australië verkorten de planningstijd voor kritieke taken met 25%. Wat dit onderscheidt van de meeste AI-claims: elk getal is gekoppeld aan een afgebakende taak met een meetbare duur of kostenpost vóór de inzet van AI. Dat maakt de business case controleerbaar en herhaalbaar. De les voor andere organisaties: begin met processen die een duidelijk meetpunt hebben, zoals inspecties of reinigingsronden, en kwantificeer de baseline voordat je automatiseert. 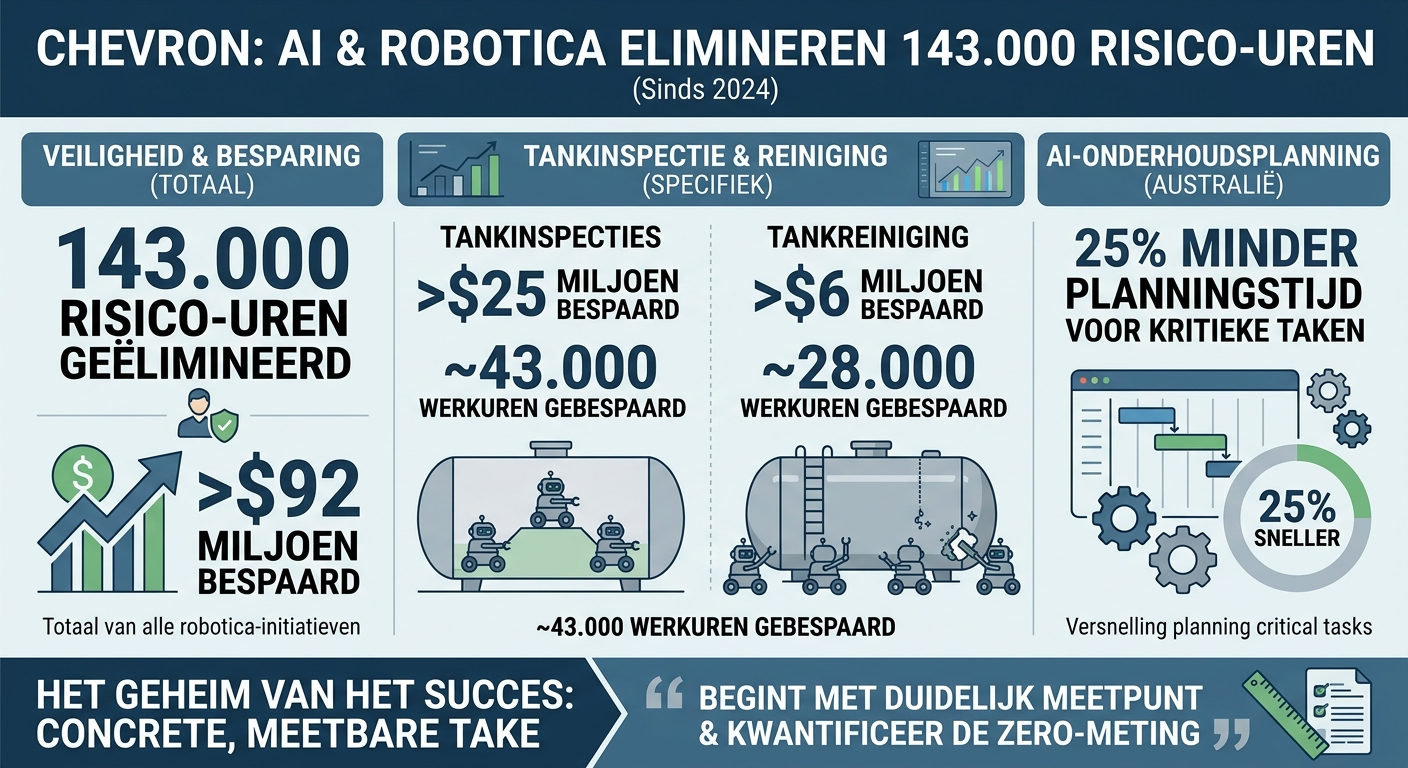
|
ChatGPT zit nu ingebouwd in Word, PowerPoint en ExcelChatGPT is beschikbaar binnen Microsoft Word, PowerPoint en Excel, ook voor gebruikers met een gratis abonnement. Je kunt dus concepten schrijven, herschrijven en nalezen zonder de applicatie te verlaten. Het praktische voordeel is duidelijk, maar de keerzijde ook: AI-uitvoer belandt nu direct in documenten die je deelt met klanten of collega's, zonder de extra stap die vroeger als natuurlijk kwaliteitsfilter werkte. Het risico zit niet in de technologie, maar in de workflow. Wie zijn prompts niet goed formuleert, produceert teksten die er officieel uitzien maar inhoudelijk vlak zijn. Denk voordat je het model aanroept na over wie de ontvanger is, wat je wilt bereiken en welke vorm het resultaat moet hebben.
|
Jev: classificaties voor fracties van een cent, geen chatbot-vervangingTypeSafe AI heeft Jev uitgebracht, een model dat classificatievragen beantwoordt zonder tekst te genereren. Eerdere nieuwsbrieven berichtten al over de lancering; inmiddels zijn er concrete gebruiksresultaten. Ontwikkelaars sorteerden 500 e-mails en scoorden 700 verkoopkansen met gepersonaliseerde berichten in circa 40 seconden voor 0,09 dollar. Een Postgres-demo verwerkte 129 rijen in ongeveer één seconde voor 0,0009 dollar. Jev werkt het best als je de vorm van het antwoord al kent, zoals een score, categorie of ja/nee-keuze, en die beslissing duizenden keren per dag nodig hebt. Het model vervangt ChatGPT of Claude niet bij complexe uitzonderingen, maar vormt een laag eronder voor routineclassificaties. Je integreert het via de TypeSafe API in workflows waar je nu een volledig taalmodel aanroept voor simpele binaire beslissingen. |