Verzonden op 05-09-2026 08:15
Cursor draait coding agents achter je eigen firewallCursor heeft cloud coding agents beschikbaar gemaakt op eigen infrastructuur, zodat code de eigen omgeving nooit verlaat. Dat was voor veel enterprise-teams de voornaamste reden om dit soort tools te mijden. Gecombineerd met het gegeven uit de vorige nieuwsbrief dat coding agents de snelst evoluerende AI-vaardigheid voor engineers zijn, wordt de drempel voor serieuze inzet in gereguleerde sectoren concreet lager. Teams in finance, zorg of overheid die tot nu toe niet konden deelnemen vanwege datavereisten, kunnen dit opnieuw evalueren. De vraag is niet meer óf agents op je codebase werken, maar hoe je ze goed begrenst. Stel eerst een duidelijke scope in: welke repositories mag de agent lezen, welke mag hij wijzigen, en wie reviewt de output? Zonder die kaders loop je het risico op onbeheerde code-aanpassingen. |
OpenAI noemt GPT-6 Astra AGI: wat dat in de praktijk betekentOpenAI heeft GPT-6 Astra uitgebracht en president Greg Brockman omschrijft het als een "generationele sprong" die het moment markeert waarop AI menselijke redenering begint te evenaren. De uitrol verloopt bewust geleidelijk vanwege cybersecurityoverwegingen, maar algemene beschikbaarheid wordt binnen enkele dagen verwacht. De vorige nieuwsbrief meldde de aanstaande lancering van Astra al. Dit is de concrete update: het model is er, met de bijbehorende AGI-claim. Voor organisaties die nu AI-pilots draaien verandert er op korte termijn weinig, maar de verwachte sprong in capaciteiten maakt het de moeite waard om bestaande use cases opnieuw te toetsen. Is een taak die drie maanden geleden te complex was voor een AI-agent, dat nu nog steeds? De AGI-framing is vooral communicatiestrategie. Concrete benchmarkcijfers en een onafhankelijke evaluatie ontbreken nog, dus houd de claims op afstand totdat die data beschikbaar zijn. Test het model via de API zodra je toegang hebt en vergelijk het op jouw specifieke taken met GPT-5 of Claude 5.1. |
Anthropic open-sourcet commerce-agent die winkelwagens 35% groter maaktAnthropic heeft een volledige blueprint voor een commerce-agent open source gemaakt. Het systeem draait op Claude en laat zien hoe een AI-agent zelfstandig producten vindt, vergelijkt en aan een winkelwagen toevoegt. In de gepubliceerde tests leverde dat een gemiddelde winkelwagengroei van 35% op. Dit is geen demo meer. De blueprint is direct te forken en te deployen, waardoor e-commerce-teams veel makkelijker met AI-agents kunnen experimenteren. Voor retailers en platformen die werken aan omzetoptimalisatie biedt dit een concreet startpunt. Het cijfer van 35% geldt voor de gepubliceerde testopstelling, dus meet het effect altijd op je eigen productcatalogus en klantgedrag. Bekijk de open-source blueprint via de repo van Anthropic en draai eerst een A/B-test op een beperkte productcategorie voordat je breder uitrolt. |
Nieuw redeneermodel lost Sudoku op met 44 keer minder rekenkrachtEen nieuw reasoning model scoort 99,5% op Sudoku-benchmarks en gebruikt daarvoor 44 keer minder rekenkracht dan vergelijkbare modellen. Dat is een signaal dat de efficiëntie van redeneermodellen snel verbetert, los van de grote frontier-modellen. Voor organisaties die redeneerintensieve taken willen automatiseren, zoals planningsproblemen, resource-allocatie of logistieke optimalisatie, dalen de kosten per taak hierdoor verder. Dat maakt toepassingen rendabel die een jaar geleden te duur waren. De benchmark is Sudoku, een gestructureerd puzzelprobleem. Hoe het model presteert op minder gestructureerde, open zakelijke vraagstukken is nog niet gepubliceerd. Controleer of de rekenkosten van je huidige AI-werklasten nog kloppen. Kleinere, efficiënt redenerende modellen kunnen op specifieke taken goedkoper zijn dan een duur frontier-model.
|
107 miljoen rijen publieke data omgezet naar doorzoekbare kaart met AI-agentsOntwikkelaar Ben Tossell heeft 107 miljoen rijen aan Britse gemeentelijke uitgavendata gescraped en omgezet naar een doorzoekbare website, vergelijkbaar met Apple Maps maar dan voor overheidsuitgaven. Het project gebruikte 656 subagents, 8,2 miljard tokens en 235 menselijke berichten. De data was publiek beschikbaar, maar verspreid over honderden gemeentesites in wisselende formaten. De agents verzamelden, normaliseerden en valideerden de data, inclusief checksum-verificatie per download. Dit laat concreet zien wat agentic workflows kunnen doen met publieke datasets die nu ontoegankelijk zijn door slechte formattering. Denk aan aanbestedingsregisters, vergunningsdatabases of subsidieoverzichten in je eigen sector. De volledige agent-sessies en bronbestanden komen open-source beschikbaar zodra de site klaar is. Volg het project voor een herbruikbaar stappenplan. 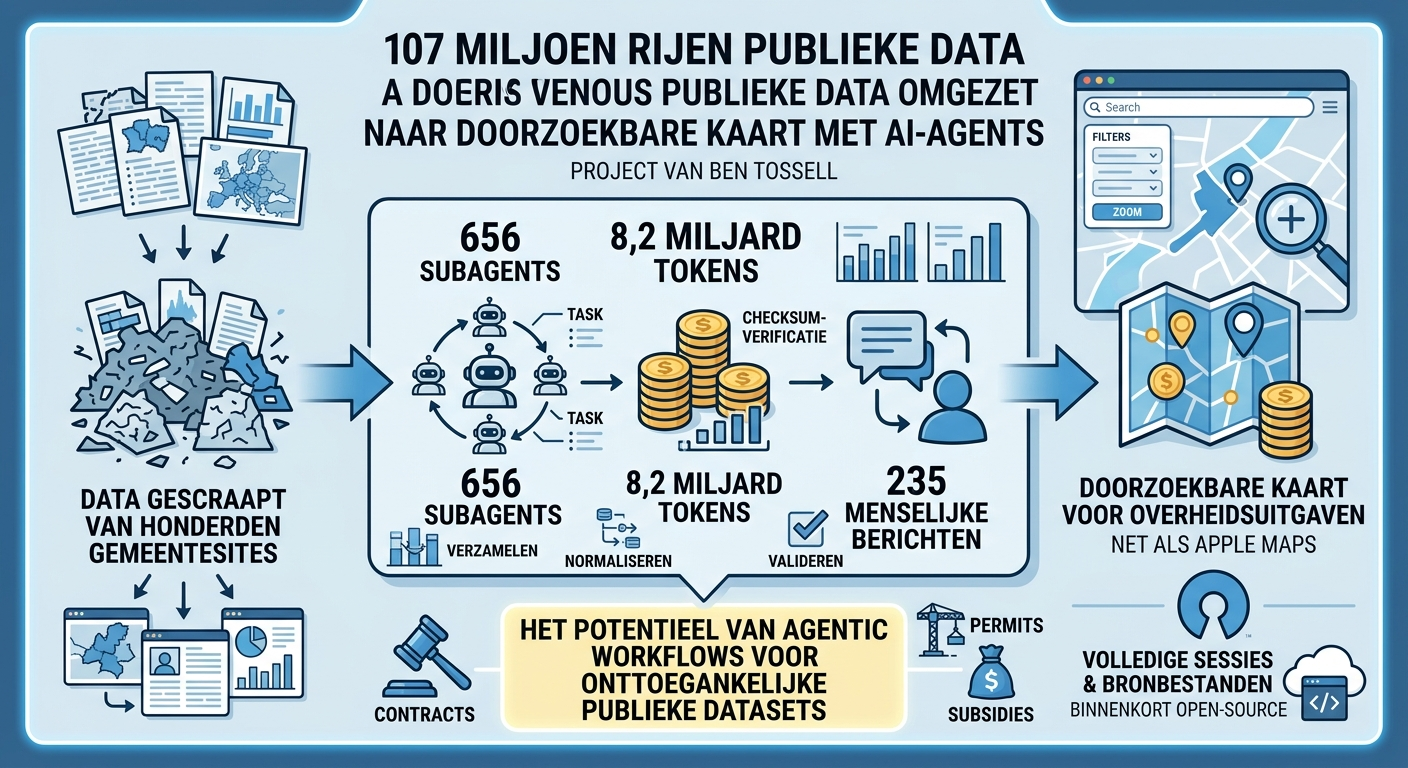
|